Keria
L'OCR (reconnaissance optique de caractères) transforme des documents scannés ou des images en texte exploitable par vos logiciels métier, ce qui permet d'automatiser la saisie de données pour vos processus bancaires ou immobiliers. Associée à des règles d'extraction de champs, cette technologie d'ocr reconnaissance texte réduit la saisie manuelle sur les contrats, factures et actes de propriété. Son intérêt pour votre organisation dépend moins de la technologie brute que de son intégration dans vos workflows existants et de la validation des données extraites.
Comment fonctionne l'OCR reconnaissance texte pour vos documents métier?
L'OCR repose sur une chaîne de quatre étapes techniques, prétraitement, segmentation, reconnaissance, reconstruction, et chacune détermine la fiabilité du texte final sur vos dossiers de crédit ou actes notariés. Ces étapes forment le socle technique de tout projet d'ocr reconnaissance texte, quel que soit le secteur d'application.
- Prétraitement: redressement des pages inclinées, suppression du bruit de fond, amélioration du contraste [5].
- Segmentation: découpage du document en zones (titres, paragraphes, tableaux, colonnes) avant isolement de chaque caractère.
- Reconnaissance: comparaison de chaque forme détectée à des motifs appris pour l'associer à une lettre ou un chiffre [5].
- Reconstruction: réassemblage des caractères en mots et phrases cohérentes, à l'aide de règles linguistiques et parfois de dictionnaires métier [2].
Cette mécanique explique pourquoi la structure du document pèse autant que la qualité de numérisation. Un tableau d'amortissement, une colonne de montants ou un tampon notarial posé sur du texte perturbent la segmentation: le moteur peut confondre une bordure de cellule avec un caractère, ou lire un montant dans le désordre si les colonnes ne sont pas clairement délimitées [1]. Un acte de propriété scanné à basse résolution ou photographié en biais dégrade la reconnaissance avant même que l'étape linguistique n'intervienne. Vous pouvez d'ailleurs tester gratuitement ce mécanisme via l'outil OCR en ligne de PDF24, qui illustre concrètement ces quatre étapes sur un document réel.
Quels formats de documents et langues l'OCR prend-elle en charge pour votre activité?
Les moteurs professionnels traitent couramment les PDF scannés, les images multi-pages (TIFF, JPEG) et les documents multilingues, ce qui couvre l'essentiel des flux bancaires et immobiliers [4]. Un dossier de prêt mêle souvent des pages en français, des pièces d'identité étrangères et des relevés bancaires issus de formats hétérogènes, la robustesse du moteur sur ces variations conditionne directement le taux d'automatisation atteignable sur l'ensemble du dossier.
Comment l'OCR traite-t-elle l'écriture manuscrite, les PDF scannés et les images de faible qualité?
L'écriture manuscrite reste le point de friction le plus net: les formes varient d'une personne à l'autre, contrairement aux polices imprimées normalisées sur lesquelles les moteurs sont entraînés [2]. Les images de faible qualité, photos de smartphone mal cadrées, scans compressés, produisent le même effet en multipliant les erreurs de segmentation. Dans ces cas, une relecture humaine ciblée sur les champs à risque (montants, signatures, mentions manuscrites) reste nécessaire pour sécuriser la donnée avant son intégration dans un système métier. Chez Keria.tech, cette logique de validation est intégrée dès la conception des outils développés pour les banques, agences et notaires, plutôt qu'ajoutée après coup.
Quelles différences de précision et de performance entre les solutions OCR pour l'entreprise?
Aucune famille de solutions ne domine sur tous les critères: les services cloud gagnent en précision sur documents complexes, les logiciels propriétaires offrent une maîtrise opérationnelle immédiate, et les moteurs open-source exigent plus d'effort mais laissent un contrôle technique total. Le bon choix dépend de ce que votre organisation est prête à maintenir en interne, pas d'un classement figé.
Comment les principales familles de moteurs OCR se comparent-elles en précision et en vitesse sur de gros volumes?
Les services cloud propriétaires s'appuient sur des modèles entraînés à large échelle et affichent généralement une meilleure précision sur des documents hétérogènes, relevés bancaires scannés, actes notariés avec tampons, compromis de vente annotés à la main. Cette précision a un coût: la dépendance à un fournisseur externe et des temps de réponse qui varient selon la charge du service au moment du traitement [5].
Les logiciels propriétaires installés en interne offrent des performances plus prévisibles sur des lots homogènes, typiquement les formulaires standardisés d'un établissement bancaire. Mais ils demandent une maintenance continue, mises à jour, calibrage selon les nouveaux formats de documents, qui pèse sur les équipes IT internes.
Les moteurs open-source permettent un contrôle total sur l'infrastructure et les données traitées, un argument fort pour les notaires et les banques soumis à des contraintes de confidentialité strictes. En contrepartie, l'intégration demande des compétences techniques internes ou un partenaire capable de les adapter à un cas d'usage métier précis, ce qui est l'approche que nous appliquons chez Keria.tech lorsque nous concevons une plateforme de traitement documentaire sur mesure pour un promoteur ou une agence immobilière.
Le traitement par lot change la donne: un volume de plusieurs centaines de dossiers par jour impose un dimensionnement d'infrastructure différent selon la solution, serveurs dédiés pour un moteur local, quotas d'appels API pour un service cloud. Une sous-estimation de ce besoin se traduit directement par des files d'attente et des retards opérationnels [2].
Quelles sont les limites spécifiques de l'OCR selon les langues ou les types de documents?
La reconnaissance de caractères accentués en français reste globalement fiable sur texte imprimé net, mais se dégrade sur manuscrit ou sur scans de mauvaise qualité [4]. Les alphabets non latins et les mises en page non standard, tableaux imbriqués, formulaires multicolonnes, documents pliés ou tamponnés, restent les cas où tout moteur OCR reconnaissance texte montre ses limites, quelle que soit la famille technologique retenue [3].
Comment intégrer l'OCR dans vos processus métier pour automatiser la digitalisation documentaire?
L'intégration réussie d'un projet ocr reconnaissance texte suit quatre étapes: audit documentaire, choix du point de connexion technique, paramétrage des règles d'extraction, puis tests sur échantillon réel avant déploiement complet.
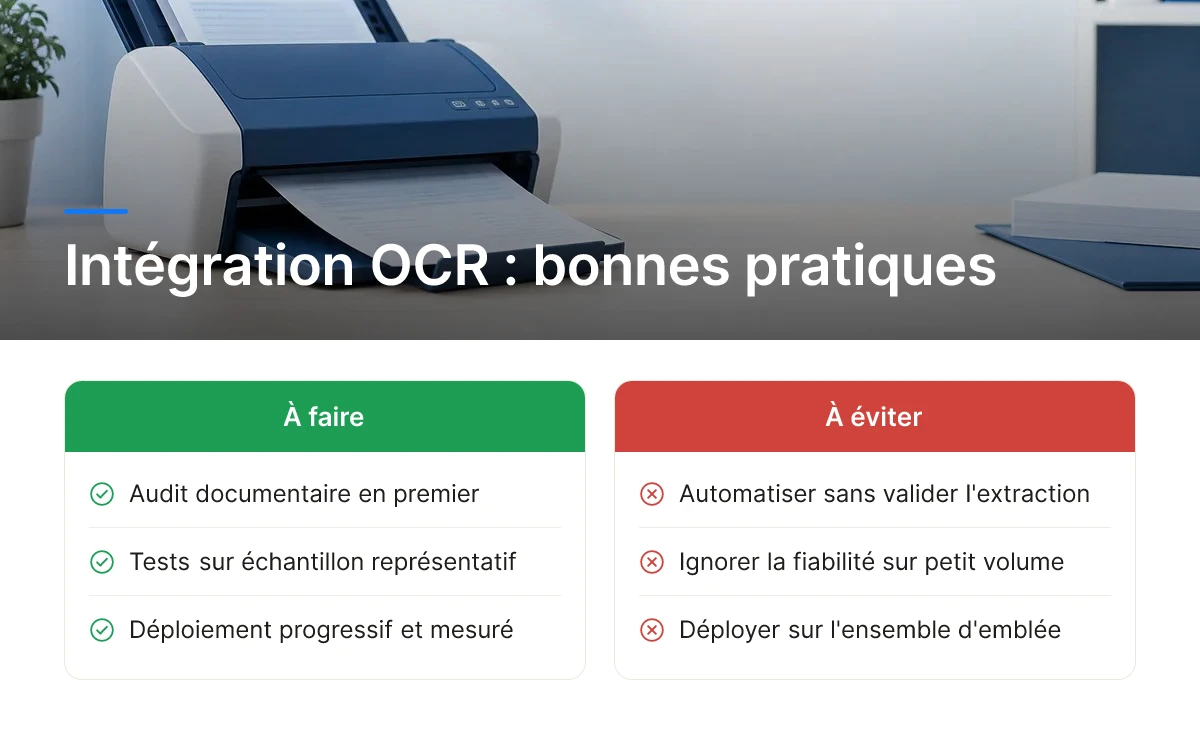
Ce séquencement évite l'erreur la plus fréquente dans les projets de digitalisation documentaire: vouloir automatiser l'ensemble d'un processus avant d'avoir validé la fiabilité de l'extraction sur un petit volume de documents représentatifs.
Quelles étapes pour intégrer l'OCR dans votre pile logicielle et vos workflows actuels?
La première étape consiste à auditer vos documents sources, actes notariés, relevés bancaires, compromis de vente, pour identifier leur format, leur qualité de numérisation et la variabilité de leur structure. Un notaire qui traite des actes authentiques standardisés n'a pas les mêmes contraintes d'extraction qu'une agence immobilière qui reçoit des diagnostics techniques sous des formats hétérogènes.
Vient ensuite le choix du point d'intégration. Trois options existent généralement:
- Une API qui s'interface directement avec votre CRM notarial ou votre logiciel de gestion documentaire.
- Un connecteur préconfiguré pour les outils bancaires courants.
- Une couche middleware qui orchestre les échanges entre l'OCR et plusieurs systèmes internes.
Cette dernière approche permet de connecter la reconnaissance de texte sans reconstruire l'architecture existante, un critère souvent déterminant pour une banque régionale dépendante d'un ERP comme Temenos ou Sopra Banking Software.
Le paramétrage des règles d'extraction définit ensuite quels champs doivent être capturés, montants, dates, identités, références cadastrales, et selon quelle logique métier. Un test sur un échantillon de 50 à 100 documents réels permet de mesurer le taux de reconnaissance avant toute mise en production.
Comment gérer la validation et la correction des erreurs dans un pipeline OCR automatisé?
Aucun système d'OCR n'atteint une fiabilité totale sur des documents manuscrits, tamponnés ou mal numérisés, d'où la nécessité d'un mécanisme de validation humaine structuré autour de seuils de confiance. Lorsque le score de confiance d'une extraction descend sous un seuil défini, le document part automatiquement dans une file de vérification manuelle plutôt que d'être traité sans contrôle.
Cette boucle de correction alimente ensuite le réentraînement du modèle, qui s'améliore progressivement sur les types de documents propres à votre activité. Pour des documents bancaires ou immobiliers sensibles, la conformité et la sécurité des données extraites ne sont pas négociables, traçabilité des accès, chiffrement, conservation limitée dans le temps. Keria.tech conçoit ces pipelines d'ocr reconnaissance texte avec une architecture pensée pour la performance et la conformité réglementaire propre aux secteurs bancaire et notarial, en intégrant la validation humaine comme étape structurelle plutôt que comme correctif a posteriori.
Quelle stratégie d'implémentation de l'OCR pour les workflows financiers et immobiliers?
La bonne approche consiste à cibler d'abord les documents standardisés avec une extraction de champs précis, puis à étendre progressivement selon les résultats mesurés.
Quelle solution OCR offre la meilleure précision pour contrats, factures et documents immobiliers?
Les formulaires de prêt, les actes notariés et les factures fournisseurs partagent une structure répétitive, montant, date, référence, signataire, qui se prête mieux à une extraction de champs ciblée qu'à une OCR générique conçue pour du texte libre. Une OCR généraliste lit l'intégralité d'une page sans distinguer ce qui compte: un numéro de compte perdu au milieu d'un paragraphe n'a pas la même valeur métier qu'une date d'échéance. AWS souligne que l'OCR permet justement de convertir une image en données exploitables et recherchables, ce qui n'a de sens opérationnel que si les champs extraits correspondent aux besoins réels du métier [5]. Pour une banque régionale qui traite des dossiers KYC, ou pour un notaire qui vérifie des références de parcelle, la précision se joue sur la capacité du système d'ocr reconnaissance texte à reconnaître la position et le format attendu de chaque donnée, pas sur sa capacité à tout lire.
Comment configurer l'OCR pour extraire des champs précis de formulaires financiers ou immobiliers standardisés?
La configuration repose sur des gabarits d'extraction: on définit, pour chaque type de document, les zones ou les motifs où apparaissent les montants, les dates, les références de parcelle ou les numéros de compte. Cette approche structurée, documentée dans les cas d'usage sectoriels de l'OCR en traitement de documents [5], réduit le taux d'erreur par rapport à une lecture non guidée, car le système sait quoi chercher et où.
Nous recommandons une démarche progressive plutôt qu'un déploiement généralisé immédiat:
- Premier temps: un pilote sur un seul type de document, un acte de vente, par exemple.
- Deuxième temps: mesure du taux de correction manuelle nécessaire sur un échantillon représentatif de dossiers.
- Troisième temps: extension aux autres flux (factures, formulaires de prêt, actes authentiques) une fois le gabarit stabilisé.
Chez Keria.tech, nous configurons cette logique d'extraction de champs selon les contraintes réglementaires propres à chaque secteur, conformité KYC pour les banques, exigences de traçabilité pour les notaires, car un projet d'ocr reconnaissance texte mal calibré sur ces spécificités génère plus de corrections manuelles que de gains réels.
Comment mesurer le retour sur investissement de l'OCR dans votre organisation?
Le retour sur investissement se mesure en comparant le coût total de possession à des gains d'efficacité mesurés avant et après déploiement, pas à une promesse générique de gain de temps. Pour une banque ou une étude notariale, cela suppose de suivre des indicateurs précis sur plusieurs mois, pas seulement d'observer une impression de fluidité.
Quels sont le coût total de possession et les délais d'implémentation selon le scénario de déploiement?
Le coût total se décompose en quatre postes: la licence ou l'abonnement à l'outil, l'intégration technique avec votre système d'information existant (ERP bancaire, logiciel métier notarial, CRM immobilier), la maintenance continue, et la formation des équipes qui vont utiliser le nouvel outil au quotidien. Ignorer l'un de ces postes fausse le calcul, une solution d'ocr reconnaissance texte peu coûteuse à l'achat peut s'avérer lourde si son intégration exige des mois de développement spécifique.
Le scénario de déploiement change radicalement le délai de rentabilisation. Un projet pilote limité à un seul type de document, par exemple les relevés de compte dans le cadre d'un dossier KYC, permet de valider la fiabilité du taux de reconnaissance avant d'engager des moyens plus larges. Un déploiement à l'échelle de l'organisation, couvrant l'ensemble des dossiers de crédit ou des actes notariés, mobilise davantage de ressources d'intégration au départ, mais répartit ensuite les gains sur un volume de documents bien supérieur. Chez Keria Tech, nous concevons les plateformes sur mesure justement pour calibrer cette montée en charge progressive, en adaptant l'architecture aux contraintes réglementaires et volumétriques propres à chaque secteur.
Quels gains d'efficacité opérationnelle et de réduction de coûts de main-d'œuvre attendre de l'automatisation OCR?
Les gains proviennent de trois mécanismes concrets: la réduction du temps passé en saisie manuelle, la diminution des erreurs de ressaisie qui génèrent des contrôles et corrections en aval, et l'accélération globale du traitement des dossiers [2]. Pour un promoteur immobilier qui traite des centaines de pièces justificatives par programme, ces trois effets se cumulent directement sur le délai de bouclage d'un dossier.
Pour objectiver ces gains, suivez trois indicateurs: le temps de traitement par document avant et après mise en place de l'outil, le taux de correction manuelle sur les données extraites, et le volume de dossiers traités par collaborateur sur une période donnée. Ces chiffres, mesurés en interne sur votre propre volumétrie, valent plus que n'importe quelle statistique sectorielle générique.
Frequently Asked Questions
L'OCR peut-elle lire du texte manuscrit sur des documents bancaires ou immobiliers?
Oui, mais avec des réserves: l'OCR classique est conçu pour du texte imprimé, pas pour l'écriture manuscrite [5]. Les technologies de reconnaissance manuscrite (ICR) existent et progressent, mais leur fiabilité reste inférieure à celle de l'OCR sur texte imprimé. Pour une annotation manuscrite sur un compromis de vente ou un bordereau bancaire, prévoyez une vérification humaine en complément.
L'OCR fonctionne-t-elle correctement sur des PDF scannés de mauvaise qualité?
La qualité du scan influence directement la précision de l'extraction [4]. Un document flou, incliné ou mal contrasté génère davantage d'erreurs de reconnaissance. Les outils récents intègrent un redressement et un nettoyage automatique des pages avant l'extraction, ce qui améliore les résultats sans remplacer un scan correctement cadré.
Peut-on extraire du texte de documents multilingues dans un même flux de traitement?
Oui, la plupart des moteurs OCR modernes gèrent plusieurs langues au sein d'un même flux de traitement [2]. Cela compte pour les notaires ou promoteurs traitant des dossiers avec des pièces d'identité étrangères. La précision varie toutefois selon la langue et l'alphabet utilisé, le latin étant généralement mieux couvert que d'autres systèmes d'écriture.
Faut-il privilégier une solution cloud ou une solution installée en interne pour des documents sensibles?
Le choix dépend de vos contraintes réglementaires et de la nature des données traitées, pas d'une règle universelle. Une banque soumise à des exigences strictes de conformité (KYC, DORA) privilégiera souvent un déploiement maîtrisant précisément la localisation des données. Une agence immobilière avec moins de contraintes peut tirer parti de la flexibilité du cloud. Keria.tech conçoit l'architecture selon vos obligations métier réelles, pas selon une préférence technologique par défaut.
Combien de temps faut-il pour déployer l'OCR sur un processus documentaire existant?
Le délai dépend du périmètre, mais un projet ciblé sur un processus précis se déploie généralement en quelques mois, pas en un an. Un pilote sur un seul type de document (relevé bancaire, acte notarié) permet de valider la précision avant d'étendre à l'ensemble du flux documentaire. L'intégration avec les systèmes existants reste souvent l'étape la plus longue.
Conclusion
L'OCR ne résout rien seule: elle devient utile quand elle s'intègre à votre workflow réel, conformité KYC pour une banque, vérification d'actes pour un notaire, gestion de dossiers pour un promoteur. Trois priorités avant tout déploiement: évaluer la qualité de vos documents sources, choisir une architecture adaptée à vos contraintes réglementaires, et tester sur un périmètre restreint avant généralisation. Keria.tech conçoit ces intégrations d'ocr reconnaissance texte sur mesure, calibrées sur votre processus métier exact plutôt que sur un outil générique. Prochaine étape concrète: identifiez le processus documentaire qui vous coûte le plus d'heures humaines ce trimestre, et évaluez s'il peut servir de pilote.
Sources & References
- ACES | ACES Population Testing™
- Understanding OCR: Practical Use Cases & Real-World Case Studies | Polygon Technology
- How OCR Enhances Business Efficiency: A Comprehensive Guide
- OCR PDF - Reconnaître le texte - 100% gratuit et en ligne - PDF24
- Qu’est-ce que l’OCR?, La reconnaissance optique de caractères expliquée, AWS
Contenu éditorial à portée informative, sans valeur contractuelle. Keria est courtier en opérations de banque et en services de paiement (COBSP), immatriculé à l'ORIAS sous le n° 26005901 (orias.fr).