Keria
La lecture automatique de documents (LAD) désigne les technologies qui capturent, analysent et extraient automatiquement les données contenues dans des documents papier ou numériques, factures, contrats, relevés, dossiers de prêt, pour les transformer en informations exploitables par vos systèmes métier. La lecture automatique documents combine reconnaissance optique de caractères (OCR), intelligence artificielle et règles métier pour classer les documents et en extraire les champs pertinents sans ressaisie manuelle. Pour les secteurs financier et immobilier, elle accélère le traitement des dossiers, réduit les erreurs de saisie et libère du temps pour les tâches à plus forte valeur ajoutée.
Qu'est-ce que la lecture automatique de documents et comment fonctionne-t-elle?
La lecture automatique documents repose sur quatre étapes techniques: capture de l'image, reconnaissance optique de caractères (OCR), extraction de données structurées, puis validation des champs identifiés.
Le terme LAD est établi depuis plusieurs décennies dans le vocabulaire de la gestion documentaire française [2]. Il désigne un ensemble de techniques qui segmentent un document numérisé, formulaire, facture, acte notarié, dossier de prêt, puis en extraient les informations textuelles pour les transformer en métadonnées exploitables [2]. La technologie mobilise aussi la RAD (Reconnaissance Automatique de Documents), qui identifie la nature d'un document à partir de sa mise en page avant même d'en extraire le contenu [3].
Quelle est la différence entre la lecture automatique de documents et la gestion électronique de documents (GED)?
La LAD extrait et interprète le contenu d'un document, tandis que la GED se charge de son classement, son stockage et sa diffusion, les deux fonctionnent en tandem, pas en concurrence [2]. Concrètement, la LAD lit un acte de vente ou un relevé bancaire et en isole les champs pertinents (montant, date, identité des parties). La GED prend ensuite le relais pour archiver ce document, le rendre consultable par les équipes concernées et respecter les obligations de conservation. Pour une agence immobilière ou un notaire, cette articulation évite la double saisie: les données extraites par la LAD alimentent directement le système de classement, sans ressaisie manuelle entre les deux couches.
Comment l'IA et le machine learning permettent-ils d'améliorer la précision de la lecture automatique?
Les moteurs OCR classiques comparent les formes détectées à des bibliothèques de caractères prédéfinies, puis vérifient les mots ambigus contre un dictionnaire intégré pour corriger les erreurs de reconnaissance [3]. L'apport du machine learning va plus loin: les modèles s'entraînent sur des volumes importants de documents variés pour apprendre à reconnaître un champ, un numéro de dossier, un montant, une adresse, même lorsque la mise en page diffère d'un émetteur à l'autre. C'est ce qui permet de traiter des documents non structurés, comme des pièces jointes hétérogènes envoyées par des usagers ou des clients [1], sans dépendre d'un modèle de formulaire figé.
Chez Keria Tech, nous concevons ces plateformes de lecture automatique en intégrant directement le contrôle qualité et l'intégration dans le système cible du client, CRM bancaire, outil métier notarial ou logiciel de gestion immobilière, pour que l'extraction alimente vos processus existants sans étape intermédiaire manuelle.
Quel rôle joue la lecture automatique documents dans la réduction des erreurs de saisie?
Chaque ressaisie manuelle introduit un risque d'erreur, une faute de frappe sur un montant, une inversion de chiffres dans une référence de dossier, une date mal reportée. La lecture automatique documents supprime cette étape intermédiaire en extrayant directement les champs depuis le document source, ce qui réduit mécaniquement le nombre de points de défaillance humaine. Pour un service qui traite plusieurs centaines de dossiers par mois, ce gain de fiabilité pèse autant que le gain de temps sur la charge de travail globale des équipes.
Comment la lecture automatique de documents s'intègre-t-elle dans vos processus métier existants?
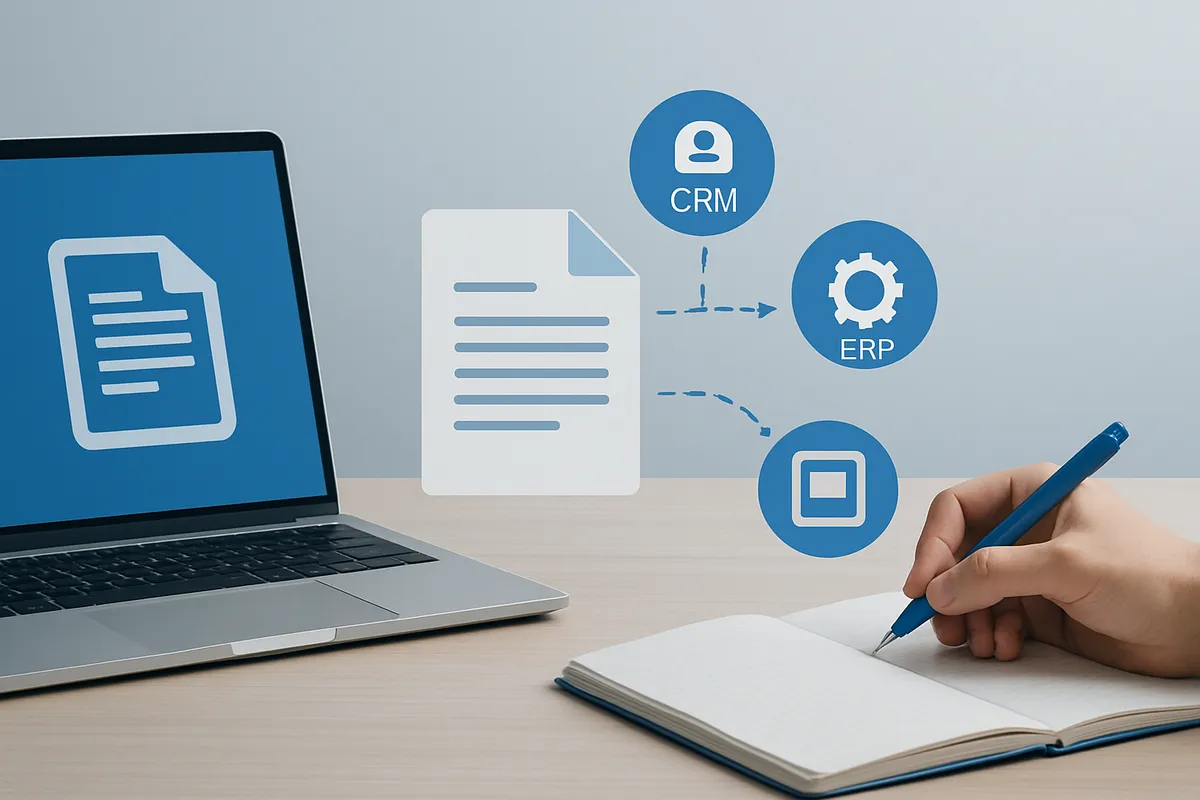
Une solution de lecture automatique documents se connecte à votre CRM, votre ERP ou votre logiciel métier via API, sans remplacer les outils que vos équipes utilisent déjà au quotidien. L'objectif n'est pas de tout reconstruire, mais d'ajouter une couche d'extraction intelligente en amont de vos systèmes existants.
Quelles sont les étapes clés pour intégrer une solution de lecture automatique à vos systèmes actuels?
L'intégration suit une séquence précise, et sauter une étape multiplie les risques de rejet par les équipes. Chez Keria.tech, nous commençons systématiquement par un audit des flux documentaires existants: quels documents arrivent, sous quel format, à quelle fréquence, et vers quel système ils doivent finir.
Vient ensuite la connexion technique proprement dite. Les API relient l'outil de lecture automatique à votre CRM bancaire, votre logiciel de gestion notariale ou votre ERP immobilier, pour que les données extraites alimentent directement les bons champs sans ressaisie manuelle. Cette architecture orientée performance évite les doubles saisies qui ralentissent le traitement d'un dossier de prêt ou d'un acte notarié.
Le paramétrage des règles d'extraction constitue la phase la plus technique: définir quels champs extraire sur un avis d'imposition, une pièce d'identité ou un compromis de vente, et selon quelle logique de validation. Une phase de test sur un échantillon réel précède toujours le déploiement complet, pour ajuster les règles avant la mise en production.
Comment la lecture automatique peut-elle servir de moteur de recherche et d'indexation pour vos documents numérisés?
Chaque document traité par un moteur de lecture automatique devient une source de métadonnées consultables, ce qui change la façon dont vos équipes retrouvent l'information. Au lieu de chercher un fichier par son nom ou sa date de dépôt, un gestionnaire de dossier peut interroger directement le contenu: montant, nom du signataire, référence de bien, date d'échéance [2].
Cette fonction d'indexation transforme un simple stockage de documents scannés en base consultable, proche d'un système de gestion électronique de documents [2]. Pour une agence immobilière qui gère des centaines de baux, ou une banque qui traite des milliers de dossiers KYC, ce gain de recherche pèse directement sur le temps de traitement par dossier.
L'implication des équipes métier dès le cadrage reste déterminante: un projet piloté uniquement par la DSI, sans les gestionnaires de dossiers ou les chargés de clientèle qui utiliseront l'outil, se heurte souvent à un rejet silencieux une fois déployé. Une approche progressive fonctionne mieux, démarrer sur un seul type de document à fort volume, comme les relevés bancaires ou les compromis de vente, avant d'étendre la lecture automatique à d'autres flux documentaires.
Comment organiser la gouvernance des données extraites une fois l'intégration réalisée?
Une fois la lecture automatique documents en place, il reste nécessaire de définir qui valide les champs extraits en cas de doute, qui corrige les anomalies signalées, et qui met à jour les règles d'extraction lorsqu'un nouvel émetteur ou un nouveau format de document apparaît. Sans cette gouvernance claire, le système accumule des exceptions non traitées qui finissent par ralentir le flux plutôt que de l'accélérer. Désigner un référent métier par type de document, factures fournisseurs, dossiers de prêt, actes notariés, permet de garder cette maintenance légère et continue.
Quels sont les cas d'usage concrets de la lecture automatique pour les secteurs financier et immobilier?
La lecture automatique documents traite en priorité les factures et bons de livraison dans les back-offices bancaires, et les dossiers de prêt, contrats de vente et diagnostics techniques dans l'immobilier, deux familles de documents à fort volume et forte répétitivité structurelle.
Comment la lecture automatique résout-elle les problèmes récurrents de traitement des bons de livraison et des factures?
Un service comptable qui reçoit des centaines de factures par mois perd un temps mesurable à ressaisir manuellement les montants, références fournisseurs et dates d'échéance. La lecture automatique de documents extrait ces champs directement depuis le PDF ou le scan, sans intervention humaine [5].
Le rapprochement automatique avec les bons de commande constitue le second bénéfice. Le système compare la facture reçue au bon de commande initial et signale les écarts, quantité, prix unitaire, référence produit, avant validation. Ce contrôle réduit les litiges liés aux erreurs de saisie, une source classique de tensions avec les fournisseurs et de retards de paiement.
Pour une banque régionale, ce même principe s'applique aux relevés de compte et justificatifs transmis par les clients lors d'une ouverture de dossier. L'extraction automatique élimine la vérification ligne par ligne qui mobilisait auparavant un conseiller ou un agent back-office.
Quels types de documents (contrats, relevés, dossiers) bénéficient le plus de l'automatisation?
Les documents à volume élevé et à structure semi-répétitive tirent le meilleur parti de l'automatisation. Un relevé bancaire, un contrat de prêt type ou un diagnostic technique immobilier suivent un format proche d'un émetteur à l'autre, ce qui permet à un moteur de lecture automatique documents d'apprendre rapidement où se trouve chaque information [3].
À l'inverse, les documents très hétérogènes, courriers manuscrits, pièces justificatives atypiques, contrats négociés au cas par cas, demandent davantage de paramétrage initial et un taux de vérification humaine plus élevé. La Reconnaissance Automatique de Documents (RAD) identifie d'abord la nature du fichier avant que l'OCR n'en extraie le contenu [3], ce qui limite les erreurs sur ces cas complexes.
Pour un courtier ou une agence immobilière, ce ciblage change la vitesse d'instruction d'un dossier. Extraire automatiquement les données d'un dossier de prêt, d'un compromis de vente et de relevés bancaires réduit le délai entre la réception des pièces et la disponibilité de l'information pour la décision. Keria.tech conçoit ce type d'outil sur mesure, calibré sur les documents réellement traités par chaque client plutôt que sur un modèle générique.
Quels bénéfices spécifiques pour les notaires et les gestionnaires de copropriété?
Les études notariales traitent un volume constant d'actes, de pièces d'état civil et de justificatifs de financement dont la structure varie peu d'un dossier à l'autre. La lecture automatique documents permet d'extraire automatiquement les identités des parties, les références cadastrales et les montants de transaction, ce qui accélère la préparation des actes sans remettre en cause le contrôle notarial final. Les gestionnaires de copropriété, confrontés à des appels de charges et des procès-verbaux d'assemblée générale récurrents, tirent un bénéfice comparable en automatisant l'extraction des montants et des échéances plutôt que de les ressaisir manuellement à chaque cycle.
Quels défis et limitations faut-il anticiper lors du déploiement d'une solution de lecture automatique?
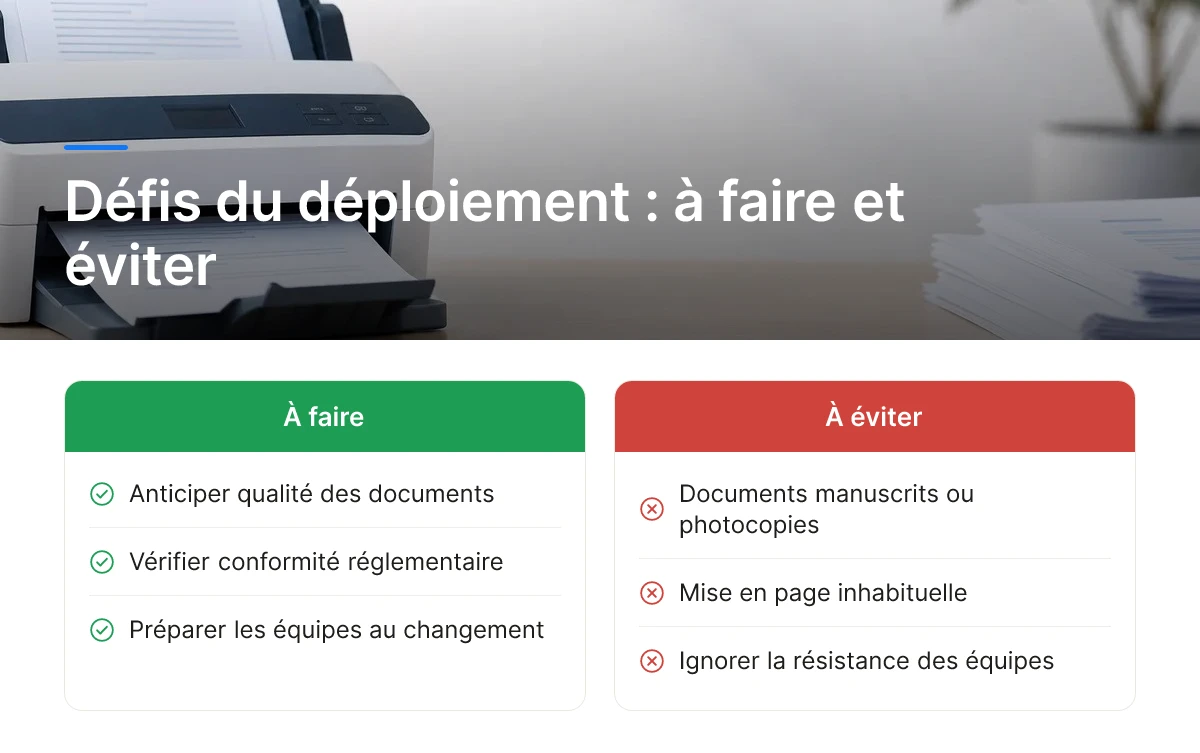
Un projet de lecture automatique documents échoue rarement à cause de la technologie seule, les blocages viennent souvent de la qualité des documents, de la conformité réglementaire ou de la résistance des équipes. Anticiper ces trois fronts conditionne la réussite du déploiement autant que le choix du moteur OCR.
Les limites techniques que les outils actuels ne résolvent pas seuls
Un document manuscrit, une photocopie de mauvaise qualité ou un formulaire avec une mise en page inhabituelle font chuter la précision d'extraction. La reconnaissance de caractères manuscrits reste moins fiable que celle du texte imprimé, en particulier sur des pièces d'identité usées ou des relevés bancaires photographiés au téléphone [3].
Pour une banque qui traite des dossiers de prêt hétérogènes, ou une agence immobilière qui reçoit des baux rédigés dans des formats variés, cette variabilité impose de garder une validation humaine sur les cas ambigus. La lecture automatique documents fonctionne mieux comme un filtre qui absorbe le volume standard et remonte les exceptions à un opérateur, pas comme un remplacement total de la vérification manuelle.
Comment garantir la conformité RGPD et la sécurité des données lors de l'automatisation du traitement documentaire?
La conformité RGPD impose de tracer chaque accès aux documents, de chiffrer les flux de bout en bout et de choisir un hébergement localisé conforme aux exigences des secteurs bancaire et notarial.
Les dossiers traités, avis d'imposition, relevés bancaires, actes notariés, contiennent des données personnelles et financières sensibles. Un incident de sécurité sur ce type de flux expose l'organisation à des sanctions réglementaires et à une perte de confiance client difficile à réparer. Chez Keria.tech, cette exigence se traduit par une architecture pensée dès la conception du projet, pas ajoutée après coup, un point que les directions conformité des banques régionales vérifient systématiquement avant tout déploiement.
La résistance au changement, un risque sous-estimé
Les équipes habituées à la saisie manuelle perçoivent parfois l'automatisation comme une menace plutôt qu'un gain de temps. Sans accompagnement, cette résistance ralentit l'adoption et pousse certains collaborateurs à contourner l'outil.
Un plan de formation ciblé, avec des cas d'usage concrets propres au métier, notaire, gestionnaire de crédit, chargé de programme immobilier, limite ce risque.
Pourquoi une phase pilote reste indispensable
Déployer d'abord sur un périmètre restreint permet de repérer les cas limites, documents rares, formats non anticipés, et d'ajuster les règles d'extraction avant la généralisation à l'ensemble des dossiers.
Comment évaluer le ROI et les coûts d'implémentation d'une solution de lecture automatique?
Le ROI d'un projet de lecture automatique documents se calcule en comparant le temps et les erreurs économisés à un ensemble de coûts qualifiables mais rarement chiffrables à l'avance sans étude préalable. La rigueur de la méthode compte plus que la précision du chiffre final, surtout en phase de cadrage.
Quels postes de coûts anticiper avant de lancer un projet?
Quatre postes reviennent systématiquement dans un projet de lecture automatique documents, quel que soit le secteur. La licence ou l'abonnement logiciel varie fortement selon le volume documentaire et la complexité des cas d'usage, un tarif budget-friendly pour un flux de quelques centaines de dossiers par mois n'a rien à voir avec une architecture premium capable d'absorber les pics d'une banque régionale en période de collecte fiscale.
L'intégration technique représente souvent le poste le plus sous-estimé: connecter l'outil à un système bancaire existant (Temenos, Sopra Banking Software ou solution maison) demande un travail de câblage que peu d'éditeurs génériques anticipent correctement. La formation des équipes et la maintenance continue, mise à jour des modèles, ajustement aux nouveaux types de documents, complètent le tableau et doivent figurer dans le budget dès le départ, pas comme une surprise en année deux.
Comment se construit le ROI concrètement?
Le calcul repose sur trois leviers mesurables. Le premier est le temps de traitement gagné par document: chaque minute économisée sur la saisie ou la vérification manuelle se multiplie par le volume mensuel de dossiers traités. Le deuxième est la réduction du taux d'erreur de saisie, qui limite les reprises de dossier, les allers-retours avec le client et les risques de non-conformité en matière de KYC ou d'anti-blanchiment.
Le troisième levier, souvent le plus significatif à moyen terme, est le redéploiement du temps des équipes vers des tâches à valeur ajoutée: conseil client, analyse de risque, accompagnement du promoteur ou du notaire sur des dossiers complexes plutôt que sur de la ressaisie.
Quels sont les indicateurs clés de performance (KPI) à suivre pour mesurer le succès d'une implémentation?
Quatre KPI suffisent pour piloter un projet sans se noyer dans un tableau de bord surchargé. Le temps moyen de traitement par dossier mesure l'effet direct de l'automatisation sur le cycle opérationnel. Le taux de documents nécessitant une correction manuelle indique la fiabilité réelle du moteur de reconnaissance sur vos types de pièces spécifiques.
Le volume traité par collaborateur révèle le gain de capacité sans recrutement supplémentaire. Le délai de mise à disposition de l'information, le temps entre la réception d'un document et son exploitation par un gestionnaire ou un conseiller, capture l'impact sur la vitesse de décision, un enjeu direct pour une agence immobilière ou un service de conformité bancaire.
Comment comparer les solutions sans se focaliser uniquement sur le prix?
Comparez les solutions par palier, budget-friendly, mid-range, premium/enterprise, en fonction de votre volume documentaire et de la criticité métier, pas en cherchant l'offre la moins chère. Un promoteur qui traite quelques dizaines de dossiers de VEFA par mois n'a pas les mêmes besoins qu'une banque régionale qui digitalise l'ensemble de son onboarding client. Keria.tech construit ce dimensionnement avec le client en amont, en calibrant l'architecture sur le volume réel et le niveau de risque métier plutôt qu'en imposant une licence standard sur-dimensionnée.
Questions fréquentes
La lecture automatique de documents peut-elle traiter des documents manuscrits?
Oui, mais avec des taux de fiabilité variables selon la lisibilité de l'écriture. Les moteurs OCR modernes couplés à des modèles d'intelligence artificielle reconnaissent des mentions manuscrites courtes, signatures, cases cochées, montants, avec de bons résultats [3]. Pour un texte manuscrit long ou peu structuré, comme des annotations libres sur un acte notarié, une vérification humaine reste recommandée avant intégration dans votre système de gestion.
Combien de temps faut-il pour déployer une solution de lecture automatique de documents?
Comptez généralement quelques semaines à quelques mois, selon la complexité de vos documents et de vos systèmes existants. Un projet ciblé sur un seul type de dossier, comme les pièces justificatives d'un prêt immobilier, se déploie plus vite qu'une intégration couvrant plusieurs métiers. Chez Keria.tech, nous calibrons chaque solution sur le workflow réel du client plutôt que d'imposer un calendrier standard.
La lecture automatique de documents remplace-t-elle complètement la saisie manuelle?
Non, elle réduit fortement la saisie manuelle sans l'éliminer totalement, surtout sur les documents complexes ou atypiques. Une part du volume, dossiers incomplets, formats non standards, mentions ambiguës, nécessite encore un contrôle humain. L'objectif réaliste est de concentrer vos équipes sur les cas exigeant un jugement métier, pas sur la ressaisie répétitive.
Quelles compétences internes faut-il pour piloter un projet de lecture automatique de documents?
Un pilote métier qui connaît le processus documentaire, plus un point de contact technique côté SI, suffisent pour démarrer. Vous n'avez pas besoin d'une équipe de data scientists en interne. L'essentiel est de désigner une personne capable de valider les règles métier, quels champs extraire, quels contrôles appliquer, pour guider le prestataire technologique.
Quels signaux indiquent qu'une organisation est prête pour la lecture automatique documents?
Un volume mensuel de documents suffisamment élevé pour justifier l'investissement, des formats de documents relativement stables d'un émetteur à l'autre, et une équipe métier disposée à formaliser ses règles de validation sont les trois signaux les plus fiables. À l'inverse, un flux très faible ou des documents extrêmement variables d'un dossier à l'autre réduisent le bénéfice attendu et méritent d'être évalués au cas par cas avant tout engagement.
Conclusion
La lecture automatique de documents transforme un poste de coût, le traitement manuel des dossiers, en un levier de rapidité et de fiabilité mesurable. Trois points à retenir: ciblez d'abord le processus le plus chronophage (KYC, dossiers de prêt, actes), exigez une architecture qui s'intègre à votre SI existant sans le remplacer, et gardez un contrôle humain sur les cas complexes plutôt que de viser 100 % d'automatisation.
Prochaine étape concrète: listez le type de document qui génère le plus de ressaisie manuelle dans votre organisation cette semaine, et évaluez son volume mensuel avant d'engager un projet pilote.
Sources & References
- Lecture automatique de documents: comment l’IA facilite vos démarches en ligne
- Lecture automatique de document, Wikipédia
- Qu’est-ce que la LAD ou Lecture Automatique de Documents?
- La lecture automatique de document (LAD) | Luminess
Contenu éditorial à portée informative, sans valeur contractuelle. Keria est courtier en opérations de banque et en services de paiement (COBSP), immatriculé à l'ORIAS sous le n° 26005901 (orias.fr).