Keria
Le traitement intelligent des documents (IDP) combine IA, machine learning et NLP pour lire, comprendre et traiter des documents non structurés, contrats, relevés, actes notariés, sans règles fixes ni intervention humaine constante. Le traitement intelligent documents se distingue de l'OCR traditionnel, qui se limite à convertir une image en texte brut, en interprétant le contexte, en extrayant les données pertinentes, en les validant et en les intégrant directement dans vos systèmes métier. Pour une banque, une agence immobilière ou une étude notariale, cela signifie moins de saisie manuelle et moins d'erreurs sur des documents à fort volume et forte variabilité de mise en page.
Qu'est-ce que le traitement intelligent des documents et comment se différencie-t-il de l'OCR traditionnel?
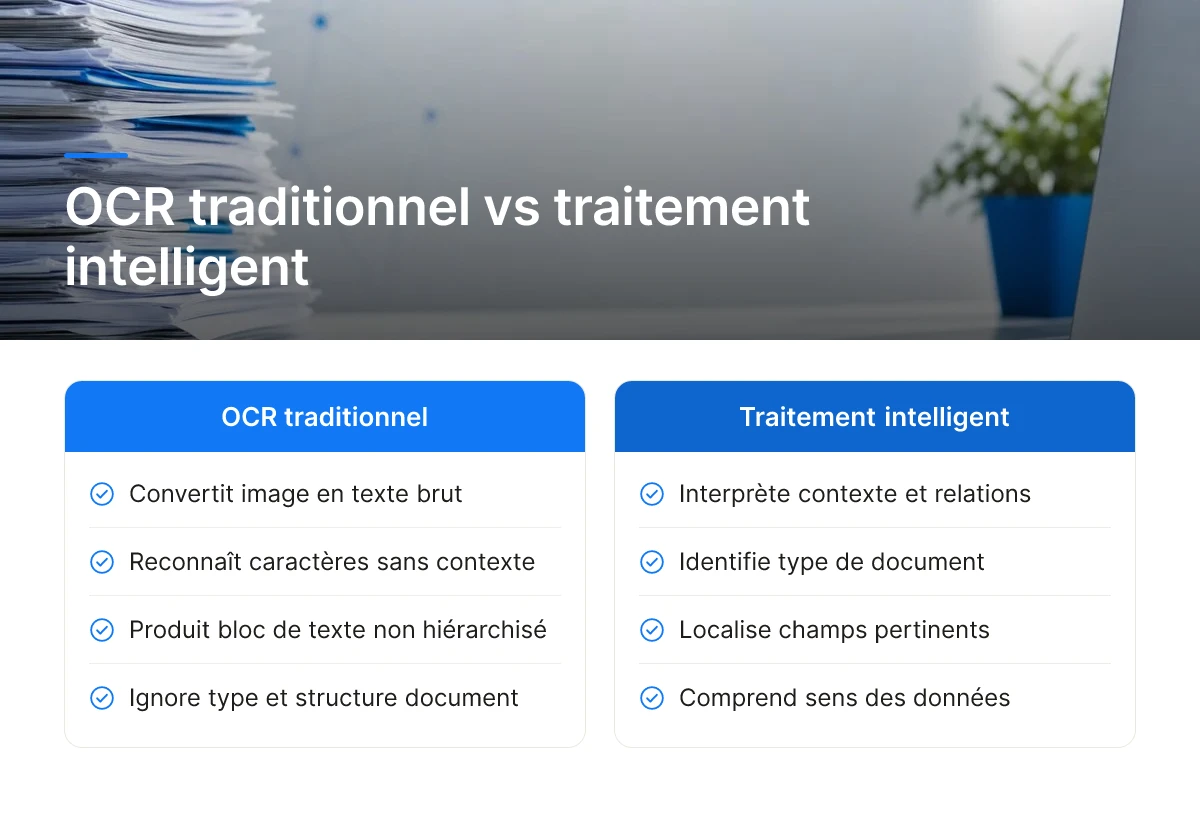
L'OCR traditionnel convertit une image en texte brut sans en comprendre la structure, tandis que le traitement intelligent documents interprète le contexte du document et les relations entre ses champs.
Concrètement, un logiciel OCR classique reconnaît des caractères sur une page scannée et produit un bloc de texte. Il ne sait pas si ce texte correspond à un montant, une date de naissance ou une adresse, il transcrit, sans hiérarchiser. Le traitement intelligent documents va plus loin: il identifie d'abord le type de document (relevé bancaire, compromis de vente, acte notarié), puis localise les champs pertinents selon leur fonction, et enfin vérifie leur cohérence avant de les transmettre à un système métier.
Quelles technologies (IA, machine learning, NLP) alimentent le traitement intelligent des documents?
Trois briques technologiques travaillent ensemble: le machine learning pour classer automatiquement les documents, le traitement du langage naturel (NLP) pour extraire les données selon leur sens plutôt que leur position fixe, et des modèles entraînés sur des milliers de formats pour s'adapter aux variations de mise en page [2].
Ces modèles apprennent à reconnaître un document même quand sa présentation change d'un émetteur à l'autre. C'est cette capacité d'adaptation qui distingue l'IDP d'un simple script de reconnaissance de zones fixes, une limite classique des outils OCR anciens [1].
Prenons un exemple courant pour une banque régionale: le champ "montant" ne se trouve jamais au même endroit selon l'établissement émetteur d'un relevé. Une banque le place en haut à droite, une autre en bas de tableau, une troisième dans un encadré séparé. Un moteur OCR classique, calé sur des coordonnées fixes, échoue dès que le gabarit change. Un système de traitement intelligent documents identifie le champ par sa fonction et son contexte, libellé associé, format numérique, position relative à d'autres données, et le retrouve de façon fiable quel que soit le document source.
Quels sont les avantages concrets du traitement intelligent des documents par rapport au traitement documentaire classique?
Le gain principal se mesure sur quatre points opérationnels précis, directement utiles pour une banque, une agence immobilière, un promoteur ou une étude notariale:
- Réduction de la ressaisie manuelle, les données extraites alimentent directement les systèmes métier sans passage par un opérateur.
- Validation automatique des incohérences, un montant qui ne correspond pas au total attendu, une date antérieure à une autre qui devrait la précéder, sont signalés avant intégration.
- Traitement de documents non structurés, emails avec pièces jointes, PDF scannés de mauvaise qualité, formulaires manuscrits, tous traités sans modèle de saisie prédéfini.
- Adaptabilité aux volumes variables, un pic de dossiers de prêt ou d'actes de vente ne nécessite pas de recrutement temporaire pour la saisie.
Pour un notaire qui traite des actes aux formats hétérogènes selon l'étude d'origine, ou une agence immobilière qui reçoit des compromis de vente sous des dizaines de gabarits différents, cette différence n'est pas théorique. Elle se traduit par des dossiers traités en heures plutôt qu'en jours, avec un niveau d'erreur nettement réduit par rapport à une saisie manuelle répétitive.
Comment le traitement intelligent documents s'intègre-t-il aux outils déjà en place dans l'entreprise?
Une préoccupation fréquente chez les responsables IT concerne la compatibilité avec l'existant. Un projet de traitement intelligent documents n'implique pas nécessairement de remplacer les logiciels métier déjà déployés. La plupart des solutions modernes s'interfacent via des connecteurs standards ou des API avec les CRM, ERP et logiciels sectoriels déjà utilisés, ce qui limite la durée du projet et évite une refonte complète du système d'information.
Cette intégration progressive permet aussi de tester l'apport du traitement intelligent documents sur un seul processus avant de l'étendre. Une banque peut par exemple commencer par automatiser l'extraction des justificatifs de revenus, sans toucher immédiatement au reste de la chaîne d'instruction des dossiers de crédit.
Comment fonctionne le traitement intelligent des documents dans un flux de travail réel?
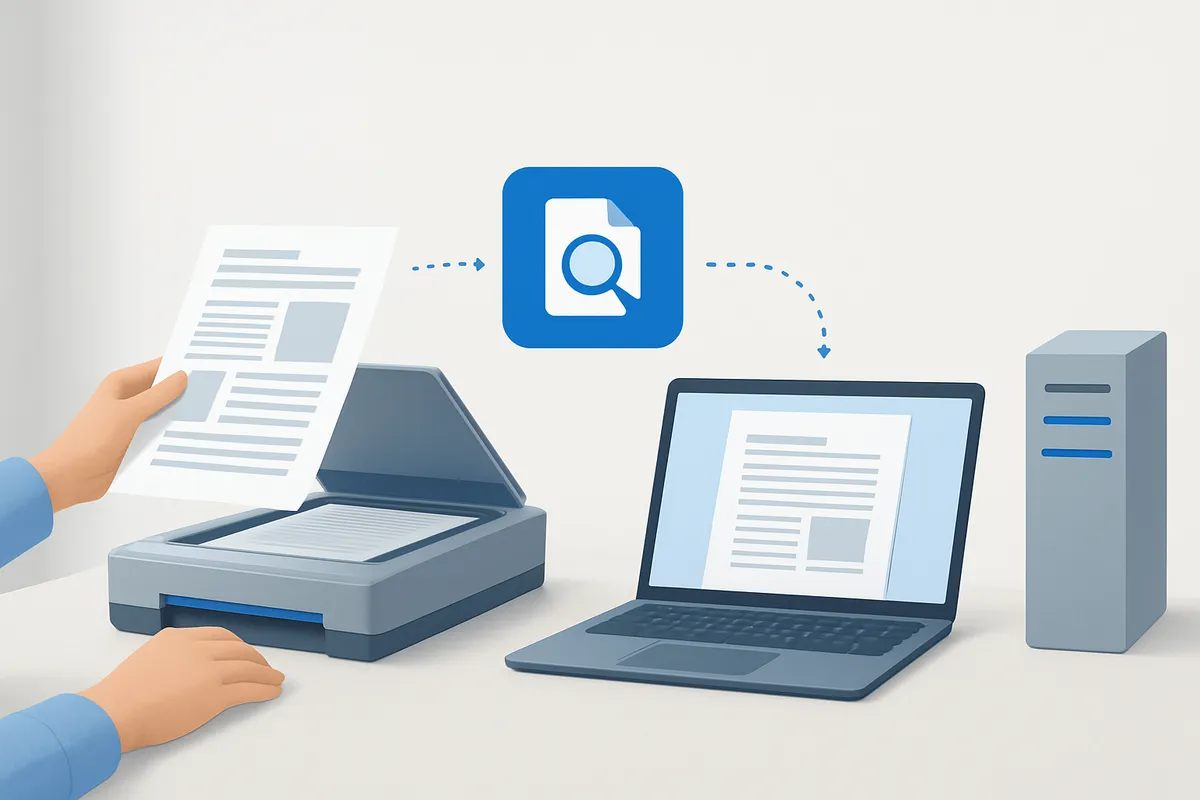
Un flux de traitement intelligent documents suit une séquence précise: capture du document, classification automatique, extraction des données, validation, puis export vers le système métier, chaque étape réduisant la part de saisie manuelle [2].
Pour un notaire qui reçoit un acte de vente ou une banque qui traite un dossier de prêt, cette mécanique remplace des heures de vérification par un flux structuré. La fiabilité du résultat dépend cependant de la qualité de chaque maillon, pas seulement de la technologie d'OCR utilisée en amont.
Quelles sont les 7 étapes clés d'une automatisation réussie du traitement des documents?
L'automatisation documentaire repose généralement sur ces étapes, quel que soit le secteur d'application [2]:
- Capture: numérisation ou réception de documents (PDF, scan, e-mail) issus de canaux multiples.
- Classification: identification automatique du type de document, avis d'imposition, relevé bancaire, compromis de vente.
- Extraction: lecture des champs pertinents (montants, identités, dates, références de parcelle) par des modèles de reconnaissance.
- Validation: contrôle de cohérence des données extraites avant intégration.
- Enrichissement: croisement avec des bases internes (KYC, registre foncier) pour compléter le dossier.
- Export: transfert automatique vers le CRM bancaire, l'ERP de l'agence ou le logiciel notarial métier.
- Apprentissage continu: correction des erreurs par un opérateur humain, réinjectée dans le modèle pour affiner les extractions futures.
Cette dernière étape, le human-in-the-loop, reste indispensable. Une écriture manuscrite ambiguë sur un acte notarié ou un champ mal renseigné sur un justificatif bancaire nécessite un arbitrage humain. Le système conserve cette correction comme référence, ce qui améliore progressivement sa précision sur des documents similaires, sans remplacer totalement le contrôle métier.
Comment gérer les enjeux de conformité (GDPR, sécurité des données) avec une solution IDP?
Une solution de traitement intelligent des documents conforme applique la minimisation des données, la traçabilité complète des traitements et une durée de conservation définie contractuellement. Concrètement, cela signifie qu'un dossier de crédit n'extrait que les champs nécessaires à l'instruction, et que chaque accès ou modification est journalisé pour un audit ultérieur.
Pour les banques et les études notariales, la sécurité impose des exigences supplémentaires: hébergement des données en France ou dans l'Union européenne, chiffrement au repos et en transit, et contrôle d'accès granulaire par rôle. Keria.tech conçoit ses architectures IDP avec ces contraintes sectorielles comme critères de conception dès le départ, plutôt que comme couche ajoutée après coup, un point souvent négligé par les outils d'extraction génériques.
Quels sont les cas d'usage du traitement intelligent des documents pour les institutions financières, agences immobilières et notaires?
Chaque secteur applique le traitement intelligent documents à un goulot d'étranglement précis: le dossier de prêt pour les banques, le mandat pour les agences, l'acte authentique pour les notaires.
Institutions financières: accélérer l'instruction des dossiers de prêt
Une banque régionale reçoit des dizaines de pièces par dossier de crédit, bulletins de salaire, avis d'imposition, relevés bancaires, justificatifs de domicile. Le traitement intelligent des documents lit ces pièces, les classe automatiquement et compare les montants déclarés avec ceux figurant sur les relevés pour repérer les écarts. Un revenu déclaré qui ne correspond pas aux virements enregistrés déclenche une alerte avant même l'intervention d'un chargé de clientèle, ce qui répond directement à la pression réglementaire KYC et anti-blanchiment évoquée par les directions de transformation digitale.
Agences immobilières et promoteurs: fiabiliser la constitution des dossiers
Un mandat de vente, un compromis et un diagnostic technique contiennent des dizaines de champs à ressaisir dans le CRM de l'agence ou le logiciel de gestion du promoteur. L'extraction automatique de ces données, surface, prix, servitudes, date de validité des diagnostics, supprime la ressaisie manuelle et réduit le délai entre la signature d'un mandat et sa mise en ligne effective.
Notaires: structurer l'acte et vérifier plus vite
Un acte notarié combine des informations cadastrales, des données d'état civil et des clauses juridiques standardisées. Structurer automatiquement ces éléments, références de parcelle, identités des parties, servitudes antérieures, réduit le temps que le clerc consacre à la vérification manuelle croisée entre l'acte et les pièces annexes.
Quels résultats mesurables (réduction d'erreurs, gain de temps) les organisations ont-elles obtenu avec l'IDP?
Les gains observés viennent de trois mécanismes concrets plutôt que d'un effet magique de l'IA. D'abord, la suppression de la double saisie: une donnée extraite une fois alimente directement le système métier, sans ressaisie ni erreur de transcription. Ensuite, la détection précoce des anomalies: une incohérence entre deux documents remonte automatiquement, avant que le dossier n'avance dans le circuit de validation, ce qui limite les corrections tardives coûteuses. Enfin, la priorisation automatique: les dossiers incomplets ou urgents sont identifiés et remontés en tête de file, au lieu d'être traités dans l'ordre d'arrivée.
Ces mécanismes expliquent pourquoi l'automatisation intelligente des documents dépasse le simple OCR [2]: elle ne se contente pas de lire un texte, elle valide, compare et déclenche des actions dans le flux de travail. C'est cette différence qui transforme un gain de productivité ponctuel en amélioration durable du processus métier, l'objectif que Keria.tech vise en concevant des plateformes calibrées sur le circuit réel d'un dossier de prêt, d'un mandat immobilier ou d'un acte notarié, plutôt qu'un outil générique adapté après coup.
Quels critères utiliser pour choisir une solution de traitement intelligent des documents adaptée à votre organisation?
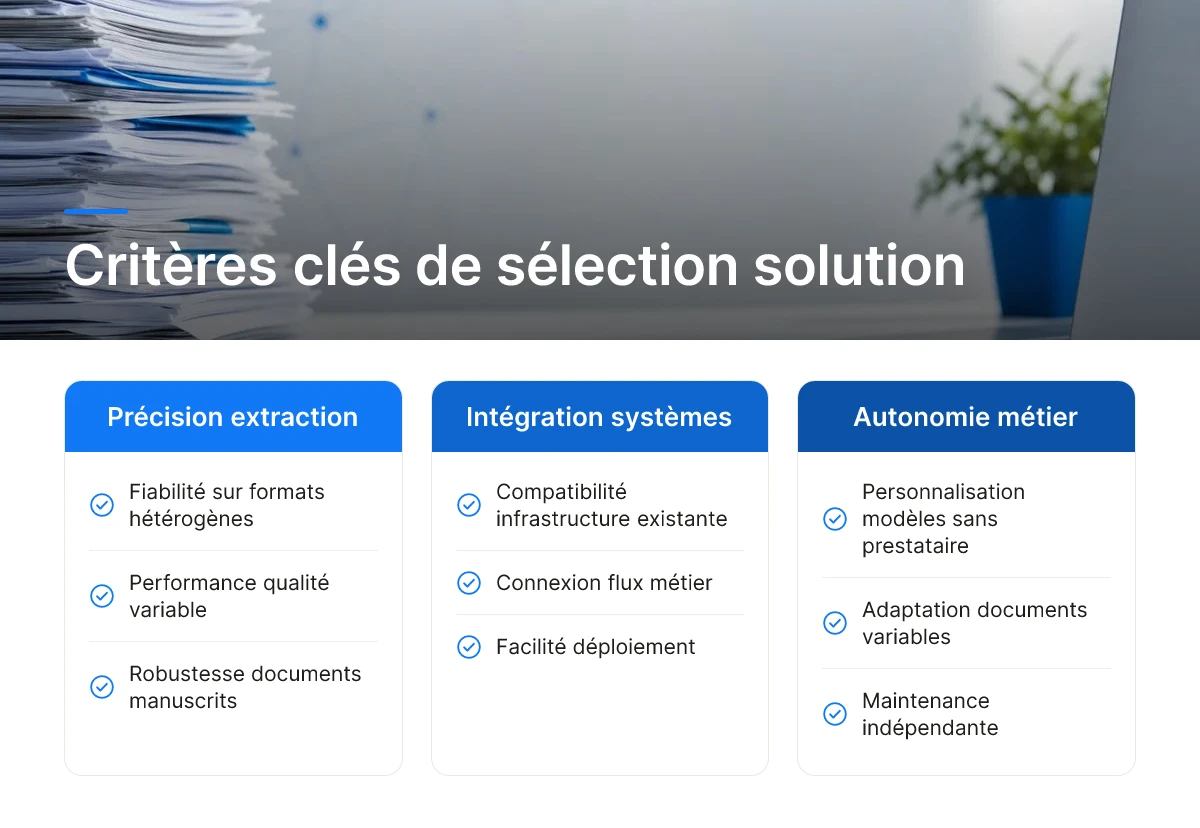
Trois critères priment: la précision d'extraction sur des documents variables, la capacité d'intégration avec vos systèmes existants, et la facilité à personnaliser les modèles métier sans dépendre en permanence d'un prestataire technique.
Un dossier de crédit immobilier, un acte notarié ou un mandat de vente n'ont pas la même structure d'un client à l'autre. Une solution de traitement intelligent documents doit maintenir un taux d'extraction fiable même sur des formats hétérogènes, scannés à des qualités variables, ou remplis à la main. Vérifiez aussi que la solution peut se connecter à votre core banking, votre CRM immobilier ou votre logiciel notarial, une plateforme qui reste isolée du reste du système d'information génère une double saisie, exactement le problème qu'elle est censée résoudre.
Faut-il opter pour une solution cloud ou on-premise pour le traitement intelligent des documents?
Le choix dépend surtout de la sensibilité des données traitées et des contraintes réglementaires de résidence des données, pas seulement du coût.
Un dossier bancaire contenant des données KYC ou un acte notarié impliquent des obligations de confidentialité strictes. Certaines banques régionales préfèrent héberger le traitement documentaire en interne ou sur un cloud privé localisé en France, pour garder un contrôle total sur la localisation et l'accès aux données. D'autres organisations, notamment les agences immobilières avec des volumes plus faibles, acceptent une solution cloud mutualisée si le fournisseur garantit une résidence des données en Union européenne. Aucune option n'est universellement meilleure, le bon choix dépend de votre politique de conformité interne et de votre exposition réglementaire.
Quels types de solutions IDP existent et laquelle convient à mes besoins métier?
Trois familles coexistent: les plateformes généralistes, les modules intégrés à un logiciel métier existant, et les solutions développées sur mesure pour un besoin précis.
Les plateformes généralistes couvrent large mais demandent souvent un paramétrage important pour coller à un métier spécifique. Les modules intégrés à un logiciel métier existant (gestion de crédit, back-office notarial) s'installent vite mais restent limités aux cas d'usage prévus par l'éditeur. Une solution sur mesure, comme celles que développe Keria.tech pour les banques, agences, promoteurs et notaires, part directement du processus métier réel plutôt que d'un produit standard, un avantage quand les documents traités sont propres à un secteur réglementé.
Un dernier critère mérite attention: la capacité d'apprentissage continu de la solution face à de nouveaux formats de documents, sans réentraînement manuel lourd à chaque évolution. Côté budget, raisonnez en paliers qualitatifs plutôt qu'en chiffres précis: une solution budget-friendly convient à de faibles volumes avec peu d'intégration, une solution mid-range répond à des besoins d'intégration modérée, et une architecture de niveau enterprise se justifie pour des volumes élevés avec des connexions multiples au système d'information existant.
Quelles questions poser à un éditeur avant de retenir sa solution de traitement intelligent documents?
Avant de signer un contrat, quelques questions permettent d'éviter les mauvaises surprises. Comment le modèle gère-t-il un format de document jamais vu auparavant? Quel est le délai moyen pour corriger et réentraîner le système après une erreur d'extraction? Où sont hébergées les données et pour combien de temps sont-elles conservées? Quel niveau d'accompagnement est prévu pendant la phase de pilote? Ces réponses distinguent souvent un éditeur capable de s'adapter à un secteur réglementé d'un outil générique mal préparé aux contraintes bancaires, immobilières ou notariales.
Quel est le retour sur investissement et les délais de mise en œuvre du traitement intelligent des documents?
Le retour sur investissement dépend de trois leviers combinés, temps de traitement récupéré, réduction des erreurs, et absorption des pics de volume, tandis que les délais varient de quelques semaines à plusieurs mois selon la diversité des documents traités.
D'où vient le retour sur investissement
Le premier gain est le temps. Un dossier de prêt, un acte notarié ou un contrat de réservation immobilière contiennent des dizaines de pièces à vérifier manuellement, chaque minute récupérée sur cette saisie se traduit directement en capacité de traitement supplémentaire pour vos équipes.
Le deuxième gain est la qualité. La ressaisie manuelle génère des erreurs qui remontent plus tard dans le processus, mauvais montant, date incohérente, pièce mal classée, et chaque correction tardive coûte plus cher qu'une vérification automatisée en amont.
Le troisième gain est l'absorption des pics. Une agence immobilière qui traite un afflux de dossiers en période de forte activité, ou une banque confrontée à un pic de demandes de crédit, n'a pas besoin de recruter en urgence si le traitement intelligent documents encaisse la charge sans dégrader les délais.
Les phases typiques d'un déploiement
Un projet IDP suit généralement quatre étapes. L'audit des documents existants identifie les formats traités, leur volume et leur variabilité. L'entraînement du modèle s'appuie ensuite sur des cas réels issus de votre activité, factures, relevés bancaires, actes, plutôt que sur des données génériques. Vient le pilote, limité à un seul processus pour mesurer l'impact avant généralisation. La montée en charge se fait ensuite processus par processus, pas en un seul déploiement global.
Ce qui allonge ou raccourcit les délais
Trois facteurs pèsent sur le calendrier. La diversité des formats de documents, un notaire qui traite des actes très structurés ira plus vite qu'une banque confrontée à des relevés hétérogènes venus de dizaines d'émetteurs. La qualité des données historiques disponibles pour entraîner le modèle. Et le degré d'intégration nécessaire avec les systèmes en place, notamment les ERPs bancaires ou les outils métier immobiliers déjà déployés.
Comment démarrer avec une solution de traitement intelligent des documents et quels sont les coûts associés?
Le point de départ le plus efficace est un processus à fort volume et faible variabilité, pour obtenir un impact mesurable avant d'étendre le périmètre. Les coûts vont du budget-friendly pour un pilote ciblé sur un seul type de document, jusqu'à l'enterprise pour une plateforme couvrant plusieurs métiers et systèmes. Keria.tech construit ces projets en partant de vos processus documentaires réels, pas d'un produit générique, pour livrer un pilote fonctionnel avant d'engager une généralisation progressive.
Frequently Asked Questions
Le traitement intelligent des documents remplace-t-il complètement l'intervention humaine?
Non, le traitement intelligent des documents ne supprime pas l'intervention humaine, il la déplace vers les tâches à valeur ajoutée. Les cas ambigus, signature illisible, document endommagé, incohérence de montant, sont toujours renvoyés à un contrôle humain. L'objectif est de réduire la saisie répétitive, pas d'éliminer la décision finale sur les dossiers sensibles, en particulier en conformité KYC ou en analyse de solvabilité.
Quelle est la différence entre traitement intelligent des documents et RPA (automatisation robotisée des processus)?
La RPA automatise des tâches répétitives selon des règles fixes, tandis que l'IDP comprend et extrait le contenu de documents non structurés [2]. Un robot RPA peut copier une donnée d'un champ à un autre, mais il ne sait pas lire un relevé bancaire scanné ou classer un acte notarié inconnu. En pratique, les deux se complètent souvent: l'IDP extrait la donnée, la RPA la fait circuler dans les systèmes métier.
Combien de temps faut-il pour qu'une solution IDP atteigne un niveau de précision fiable?
Compter plusieurs semaines à quelques mois selon le volume et la variété des documents traités. Les modèles d'extraction s'améliorent avec chaque correction humaine validée, un mécanisme d'apprentissage continu propre à l'IDP [2]. Un déploiement calibré sur un seul type de document, un acte de vente, par exemple, atteint généralement une fiabilité exploitable plus vite qu'un déploiement multi-documents dès le départ.
L'IDP fonctionne-t-il avec des documents manuscrits ou uniquement des documents imprimés?
Les solutions IDP modernes traitent aussi l'écriture manuscrite grâce à la reconnaissance HTR, en complément de l'OCR classique. Certains éditeurs, comme DocuWare, intègrent explicitement cette reconnaissance d'écriture manuscrite à leur offre [5]. La précision reste toutefois plus variable sur le manuscrit que sur l'imprimé, surtout pour une écriture peu soignée.
Quels risques de conformité faut-il anticiper avant de déployer une solution IDP en France?
Le risque principal concerne la protection des données personnelles extraites de documents sensibles, pièces d'identité, relevés bancaires, actes notariés. Une organisation régulée doit vérifier l'hébergement des données, la traçabilité des extractions et l'auditabilité des décisions automatisées, en particulier pour les obligations KYC et anti-blanchiment. Un déploiement mal cadré crée un risque réglementaire plus grand que le gain d'efficacité recherché.
Conclusion
Le traitement intelligent des documents ne se résume pas à scanner plus vite: c'est la capacité à extraire, valider et faire circuler une donnée fiable sans ressaisie manuelle. Pour une banque régionale ou une étude notariale, le gain concret se mesure en heures récupérées par dossier et en erreurs évitées avant qu'elles ne remontent en conformité. Avant de choisir un outil, cadrez d'abord un seul type de document à fort volume, dossier de prêt, acte de vente, et mesurez le temps de traitement actuel. Keria.tech peut vous accompagner pour transformer ce diagnostic en plateforme sur mesure de traitement intelligent documents, calibrée sur votre volume réel plutôt que sur une solution générique.
Sources & References
- Qu'est-ce que le traitement intelligent des documents?, Présentation de l'IDP, AWS
- Qu'est-ce que le traitement intelligent des documents? | Parseur®
- Intelligent Document Processing DocuWare
Contenu éditorial à portée informative, sans valeur contractuelle. Keria est courtier en opérations de banque et en services de paiement (COBSP), immatriculé à l'ORIAS sous le n° 26005901 (orias.fr).