Keria
L'extraction automatisée de données dans les dossiers de crédit immobilier consiste à utiliser l'IA pour lire, identifier et structurer les informations d'un emprunteur (revenus, charges, pièces d'identité, relevés bancaires) directement depuis des documents scannés ou des PDF, sans ressaisie manuelle. L'extraction données dossiers crédit relie deux besoins concrets: la vitesse de traitement d'un dossier et la fiabilité des données transmises aux systèmes d'octroi. Pour une banque, cela réduit le temps passé par un chargé de clientèle à vérifier et recopier des champs, tout en limitant les erreurs de saisie qui retardent une décision de crédit.
Comment fonctionne l'extraction automatisée de données des dossiers de crédit?
Le mécanisme repose sur un pipeline en quatre étapes: ingestion du document, reconnaissance de sa structure, extraction des champs pertinents, puis validation avant export vers le système d'octroi. Chaque étape s'appuie sur un modèle d'IA entraîné à comprendre non seulement le texte, mais aussi sa position et sa signification dans le document.
Concrètement, un dossier arrive sous forme de scan, de PDF ou même de photo prise avec un smartphone. Le moteur d'extraction données dossiers crédit repère d'abord le type de document, bulletin de salaire, avis d'imposition, relevé bancaire, puis localise les champs attendus: nom, revenus nets, charges mensuelles, numéro de compte. Une fois les données extraites, un contrôle de cohérence vérifie leur plausibilité avant que le tout ne soit envoyé, structuré, vers le logiciel métier de la banque.
Quels types de documents et de formulaires de crédit l'IA peut-elle traiter automatiquement?
Les outils actuels traitent la majorité des pièces qui composent un dossier de prêt immobilier standard. On retrouve typiquement les bulletins de salaire, les avis d'imposition, les relevés bancaires des trois derniers mois, les pièces d'identité et les compromis de vente [5]. Un dossier d'octroi de prêt comporte généralement une quinzaine d'attributs de données à collecter et vérifier avant instruction [5], ce qui rend la variété documentaire aussi large que le processus de crédit lui-même.
Cette diversité impose que le système reconnaisse chaque format sans configuration manuelle préalable, document par document.
Quelles différences entre l'extraction par IA et les solutions traditionnelles de traitement de documents?
Un OCR traditionnel se contente de transformer une image en texte brut, sans comprendre à quoi correspond chaque information. L'IA d'extraction moderne combine reconnaissance optique, traitement du langage naturel et apprentissage automatique pour identifier le rôle de chaque champ, un montant en haut à droite d'un bulletin de salaire est reconnu comme le salaire net, pas comme une charge [1]. Cette compréhension contextuelle permet de gérer des entrées désordonnées du monde réel, y compris des formulaires manuscrits ou des scans de mauvaise qualité [1]. Le principal défi technique reste la variabilité des formats: chaque banque, chaque employeur, chaque administration fiscale présente ses documents avec une mise en page différente. Une solution d'Intelligent Document Processing performante doit s'adapter à cette hétérogénéité sans reparamétrage constant, en s'appuyant sur des contrôles de conformité et de cohérence pour limiter les erreurs [2]. Keria Tech conçoit ce type de plateforme sur mesure pour les banques, en calibrant les modèles d'extraction sur les formats de documents réellement reçus par chaque établissement plutôt que sur un standard générique.
Quel rôle joue l'apprentissage continu du modèle dans la qualité de l'extraction?
Un moteur d'extraction données dossiers crédit ne reste pertinent dans la durée que s'il apprend des corrections effectuées par les équipes. Chaque fois qu'un analyste corrige un champ mal reconnu, cette correction peut être réinjectée pour affiner le modèle sur les formats spécifiques rencontrés par l'établissement. Ce mécanisme d'amélioration continue distingue une solution figée d'une plateforme réellement adaptée aux réalités documentaires d'une banque régionale, où les formats de bulletins de salaire ou de relevés bancaires varient fortement d'un employeur ou d'une agence à l'autre.
Quels sont les avantages concrets de l'automatisation pour le traitement des dossiers de crédit?
L'automatisation de l'extraction données dossiers crédit supprime la ressaisie manuelle, réduit les erreurs qui provoquent des refus, et raccourcit le délai entre le dépôt du dossier et la réponse de principe.
De combien de temps et de coûts peut-on réduire le traitement manuel des dossiers?
Le mécanisme est simple à comprendre: chaque champ extrait automatiquement d'un relevé bancaire, d'une fiche de paie ou d'un avis d'imposition est un champ que votre chargé de clientèle n'a plus à retaper à la main. Sur un dossier de crédit immobilier qui compile souvent une vingtaine de pièces différentes, cette suppression de la saisie manuelle change directement le volume de dossiers qu'une équipe peut traiter en parallèle.
La réduction des allers-retours pour pièces manquantes ou illisibles compte tout autant. Un système d'extraction bien calibré signale immédiatement un document flou, incomplet ou incohérent, au lieu que l'anomalie soit découverte trois jours plus tard par un analyste, ce qui oblige à recontacter l'emprunteur et à relancer tout le circuit de traitement. Cette logique de contrôle de conformité et de cohérence dès l'entrée du document figure d'ailleurs parmi les fonctionnalités clés que proposent les solutions d'Intelligent Document Processing appliquées au secteur bancaire [2].
Comment l'automatisation accélère-t-elle les décisions de crédit et améliore-t-elle l'expérience client?
Un dossier analysé plus vite se traduit mécaniquement par une réponse de principe plus rapide pour l'emprunteur, un facteur décisif quand un candidat à l'achat compare plusieurs banques ou négocie un délai de compromis serré. Le traitement de documents en banque vise justement des temps de traitement plus rapides, une meilleure expérience client et une conformité réglementaire renforcée [4].
La réduction des erreurs de saisie a un effet direct sur le taux de refus: une donnée mal transcrite (revenu, charge, durée de prêt) peut fausser le calcul de capacité d'emprunt et entraîner un rejet évitable ou une demande de complément qui ralentit tout le dossier.
Libérer les chargés de clientèle de la saisie répétitive leur permet de recentrer leur temps sur l'analyse de risque et le conseil à l'emprunteur, deux tâches où leur expertise humaine apporte une valeur que l'automatisation ne remplace pas. Keria.tech conçoit ce type de plateforme sur mesure, calibrée sur les processus internes d'une banque régionale plutôt qu'imposée comme un outil générique.
Quelles exigences de conformité et de sécurité s'appliquent à l'extraction données dossiers crédit?
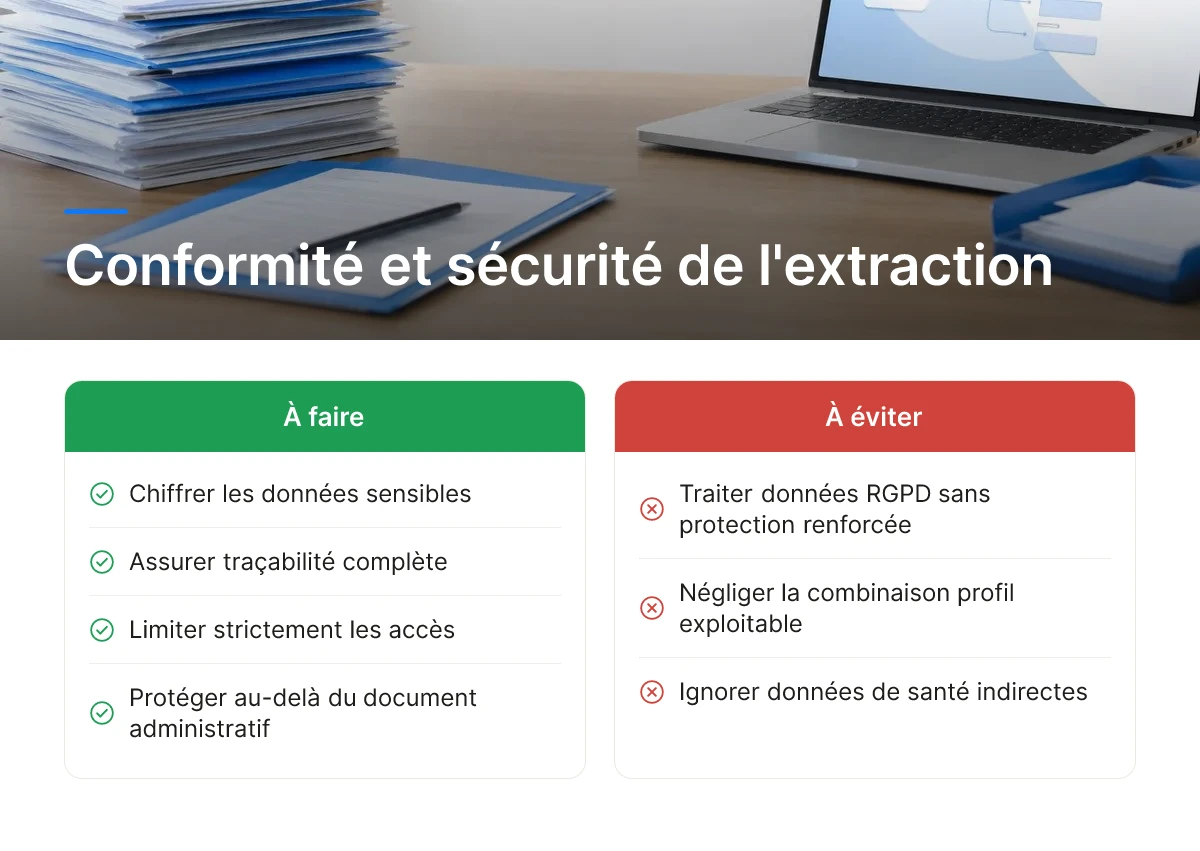
L'extraction données dossiers crédit implique le traitement automatisé de données classées sensibles au sens du RGPD, ce qui impose chiffrement, traçabilité et limitation stricte des accès. Un dossier de crédit contient des informations financières, une identité complète et parfois des données de santé indirectes (assurance emprunteur), leur combinaison crée un profil exploitable qui justifie un niveau de protection renforcé, bien au-delà d'un simple document administratif.
Pour une banque régionale ou une agence immobilière qui traite plusieurs centaines de dossiers par mois, cette exigence ne relève pas de la théorie juridique. Elle conditionne directement le choix de l'outil d'automatisation et son architecture technique.
Comment garantir la conformité RGPD lors de l'extraction de données sensibles?
La conformité RGPD repose sur quatre principes concrets appliqués à chaque champ extrait d'un dossier de crédit. La minimisation des données impose de ne capturer que les champs strictement nécessaires à l'analyse du dossier, un système qui extrait l'intégralité d'un relevé bancaire sans distinguer les lignes utiles crée un risque disproportionné.
La finalité déterminée oblige à documenter pourquoi chaque donnée est collectée, pour quel usage précis (scoring, vérification KYC, calcul du taux d'endettement). La durée de conservation limitée impose une purge automatique une fois le dossier clôturé ou le délai légal écoulé. Enfin, la traçabilité des traitements exige un historique complet: quelle donnée a été extraite, par quel processus, à quelle date. Ces principes ne sont pas des cases à cocher, ils structurent directement la manière dont une plateforme d'extraction données dossiers crédit doit être conçue dès le départ.
Quels standards de sécurité des données doivent être respectés pour les dossiers de crédit?
Trois mécanismes techniques forment le socle attendu par les établissements bancaires. Le chiffrement protège les documents en transit (lors du transfert vers l'outil d'extraction) et au repos (une fois stockés), rendant les données illisibles en cas d'interception. Le contrôle d'accès par rôle limite la visibilité des données extraites aux seuls collaborateurs habilités selon leur fonction, un chargé de clientèle n'a pas besoin de voir les mêmes champs qu'un analyste risque. L'hébergement doit répondre aux exigences propres au secteur bancaire, avec des garanties de localisation et de résilience des données.
L'auditabilité complète ce dispositif: pouvoir démontrer, lors d'un contrôle interne ou d'une inspection réglementaire, qui a accédé à quelle donnée extraite et à quel moment. Keria.tech intègre ces mécanismes de sécurité et de traçabilité comme critères de conception dès la phase de développement, plutôt que comme correctifs ajoutés après coup.
Comment intégrer une solution d'extraction de données dans vos processus bancaires existants?
Intégrer une solution d'extraction données dossiers crédit demande une connexion technique aux systèmes en place, un pilote limité avant le déploiement, et une gestion active de la résistance des équipes. Ce n'est pas un projet informatique isolé, c'est un chantier qui touche à la fois votre système d'information et vos habitudes de travail.
Quelles étapes techniques pour connecter une API d'extraction aux systèmes bancaires actuels?
La première étape consiste à identifier précisément les systèmes cibles: CRM client, LOS (Loan Origination System) pour le suivi des dossiers, et les outils métier utilisés par vos chargés d'affaires. Chaque système a ses propres champs, ses propres formats de données, et souvent son propre historique technique, parfois vieux de plusieurs années.
Une fois ces systèmes cartographiés, la connexion se fait généralement via API, ce qui permet à la solution d'extraction de transmettre les données directement sans ressaisie manuelle. Vient ensuite le mapping: chaque champ extrait du document (revenu, apport, durée du prêt, type de contrat) doit correspondre à un champ précis dans votre système interne. Cette étape de mapping est souvent sous-estimée, alors qu'elle conditionne la fiabilité de toute la chaîne. Chez Keria.tech, cette phase de connexion s'appuie sur une architecture pensée pour s'intégrer à des ERPs bancaires existants sans exiger de refonte complète du système d'information.
Quels défis rencontre-t-on lors de la mise en œuvre et comment les surmonter?
Avant tout déploiement à grande échelle, une phase pilote sur un volume limité de dossiers, quelques dizaines à quelques centaines, permet de mesurer la fiabilité réelle de l'extraction sur vos propres documents, souvent plus hétérogènes que prévu.
Trois freins reviennent systématiquement. D'abord, la résistance au changement des équipes qui ont bâti leur expertise sur la vérification manuelle. Ensuite, l'hétérogénéité des formats reçus, scans de mauvaise qualité, formulaires manuscrits, PDF mal structurés. Enfin, la nécessité de revalider les règles métier existantes, car un moteur d'extraction ne remplace pas les critères d'éligibilité déjà en place.
Pour surmonter ces obstacles, trois leviers fonctionnent: former les équipes à interpréter les résultats plutôt qu'à les subir, instaurer une boucle de validation humaine sur les cas ambigus, et suivre progressivement le taux d'extraction correcte pour ajuster les paramètres avant d'élargir le déploiement.
Comment accompagner le changement auprès des équipes métier?
L'adoption d'un outil d'extraction données dossiers crédit se joue autant sur la conduite du changement que sur la performance technique du modèle. Un chargé de clientèle habitué à vérifier chaque champ manuellement peut percevoir l'automatisation comme une remise en cause de son savoir-faire plutôt qu'un gain de temps. Impliquer les équipes dès la phase pilote, en leur montrant concrètement les cas où l'outil se trompe et pourquoi, aide à construire une confiance progressive plutôt qu'une adoption imposée depuis la direction.
Quel retour sur investissement attendre de l'extraction automatisée de données de crédit?
Le retour sur investissement se calcule en comparant le temps de traitement d'un dossier avant et après automatisation, valorisé au coût horaire moyen d'un chargé de clientèle, auquel s'ajoute la réduction du nombre de dossiers rejetés pour erreur de saisie. Cette méthode reste qualitative tant que vous n'avez pas vos propres données de production, mais elle donne un cadre solide pour bâtir un dossier d'investissement auprès de votre direction générale.
Comment calculer le retour sur investissement d'une solution d'extraction automatisée?
La formule de base tient en trois variables: le temps agent économisé par dossier, multiplié par le volume mensuel de dossiers, moins le coût de la solution elle-même. Un projet d'extraction données dossiers crédit doit aussi intégrer la baisse du taux de rejet lié aux erreurs de saisie manuelle, car chaque dossier renvoyé pour correction représente un coût de retraitement complet, nouvelle vérification, nouvel envoi au client, nouveau contrôle de conformité.
Distinguez les gains directs des gains indirects. Les gains directs sont mesurables immédiatement: heures de saisie économisées, réduction du coût de main-d'œuvre par dossier traité. Les gains indirects sont plus difficiles à chiffrer mais tout aussi réels: une meilleure satisfaction client liée à des délais de réponse plus courts, et la capacité à absorber davantage de dossiers sans recruter de personnel supplémentaire. Pour une banque régionale qui ne peut pas se permettre d'ouvrir un poste à chaque hausse de volume, ce second type de gain pèse souvent plus lourd que la seule économie de temps.
Quelles métriques de performance mesurer pour justifier le passage à l'automatisation?
Trois indicateurs suffisent à suivre la performance dans la durée. Le taux d'extraction correcte mesure la proportion de champs extraits sans erreur, un chiffre à comparer régulièrement avec les corrections effectuées par vos équipes. Le délai moyen de traitement d'un dossier, du dépôt des pièces à la décision, donne une vision directe de l'accélération obtenue. Le taux de dossiers nécessitant une intervention manuelle complète le tableau: plus il baisse, plus la solution tient ses promesses sur la durée.
Sur le positionnement tarifaire, les solutions d'intelligent document processing se répartissent en paliers qualitatifs plutôt qu'en grille fixe. Une offre d'entrée de gamme convient à un volume de dossiers limité et une intégration légère au système existant. Un palier intermédiaire correspond à des besoins de connexion avec plusieurs outils métier. Un palier premium s'adresse aux institutions qui traitent un volume élevé de dossiers avec des exigences de conformité poussées, c'est typiquement le terrain sur lequel Keria.tech conçoit des plateformes calibrées sur le volume réel et les contraintes réglementaires de chaque banque, sans licence imposée ni sur-dimensionnement inutile.
Le vrai test du retour sur investissement arrive lors d'un pic de demande de crédit, par exemple après une baisse de taux. Une équipe qui absorbe ce pic sans heures supplémentaires ni recrutement temporaire valide, dans les faits, l'investissement fait dans l'automatisation.
Frequently Asked Questions
L'extraction automatisée fonctionne-t-elle avec des documents manuscrits ou de mauvaise qualité?
Oui, dans une certaine mesure, les moteurs combinant OCR et apprentissage automatique lisent des formulaires manuscrits, des PDF scannés et des contrats signés [1]. La fiabilité dépend toutefois de la netteté du scan et de la régularité de l'écriture. Sur un dossier de crédit avec pièces photographiées au smartphone, prévoyez un contrôle humain renforcé sur les champs à faible score de confiance plutôt qu'une validation automatique intégrale.
Faut-il remplacer entièrement la vérification humaine par l'extraction automatisée?
Non, l'extraction automatisée réduit la saisie manuelle, elle ne supprime pas le contrôle humain sur les décisions sensibles. Pour un dossier de crédit immobilier, la conformité KYC et la lutte contre la fraude exigent des contrôles de cohérence [2] qu'un analyste doit superviser. Le gain se situe sur le temps de préparation du dossier, pas sur la décision finale d'octroi.
Combien de temps prend la mise en place d'une solution d'extraction dans une banque?
Cela varie selon la complexité de votre système d'information existant et le nombre de types de documents à traiter. Une solution bien pensée s'interface comme une brique logique dans vos processus déjà en place plutôt que d'imposer une refonte complète [2]. Chez Keria.tech, nous calibrons le calendrier sur le processus métier ciblé, onboarding client ou instruction de dossier, pour livrer des résultats mesurables sans attendre une transformation globale du SI.
L'extraction de données de crédit fonctionne-t-elle pour tous les types de prêts immobiliers?
Le principe s'applique à la plupart des dossiers de prêt immobilier, mais chaque type de crédit mobilise des pièces justificatives différentes. Un modèle de données d'octroi de prêt distingue généralement une quinzaine d'attributs et autant d'activités à extraire selon le produit [5]. Un prêt professionnel ou un financement promoteur demande donc un paramétrage spécifique, pas un modèle unique.
Quels indicateurs suivre après le déploiement pour s'assurer que l'extraction reste fiable?
Une fois la solution en production, surveillez régulièrement le taux de champs corrigés manuellement par type de document, car une hausse soudaine signale souvent l'arrivée d'un nouveau format non reconnu. Il est également utile de suivre le délai moyen entre la réception d'un dossier et sa disponibilité complète dans le système d'octroi, ainsi que le nombre de dossiers bloqués pour anomalie détectée automatiquement.
Conclusion
L'extraction automatisée de données de dossiers de crédit ne remplace pas vos équipes, elle leur redonne du temps sur l'analyse et la relation client. Trois points à retenir: le contrôle humain reste indispensable sur les décisions d'octroi, la qualité des documents sources conditionne la fiabilité des résultats, et l'intégration doit s'adapter à votre système d'information existant plutôt que l'inverse. Avant de lancer un projet, cartographiez un seul processus critique, onboarding ou instruction de prêt immobilier, et mesurez le temps de traitement actuel. Ce chiffre de départ deviendra votre référence pour évaluer tout gain futur.
Sources & References
- Les meilleures solutions d’IA pour automatiser l’extraction de données à partir de documents
- BEWAI - francenum.gouv.fr
- Banque et IA: Augmenter la productivité grâce à un traitement rapide et précis des documents | CambioML Blog
- Modèle de données: octroi de prêts
Contenu éditorial à portée informative, sans valeur contractuelle. Keria est courtier en opérations de banque et en services de paiement (COBSP), immatriculé à l'ORIAS sous le n° 26005901 (orias.fr).